
「SvR-1」Don't Mozheng. /oh
Problem Description
题目背景
Problem Number:
在 Guluo Academic 群中,大家正在魔怔。
需要《魔怔导论》(目前更新至 v1.1.1 版本)的 PDF 请于下方「题目附件」处下载。
题目描述
你得到了 条信息,这些信息共有三种类型(注意 描述一个名为 的字符串,该字符串不含空格、字符 与 ,不含两边的尖角括号):
- 形如 。意为接下来一行的一条信息是名为 的用户发的。
- 形如 。意为一条名称为 的表情信息。
- 形如 。意为一条内容为 的文字信息。
你经过长期观察,发现名称为 和 的表情信息具有魔怔的意味。
并且在一段对话中:
- 一个 表情会增加 的魔怔值。
- 一个 表情会增加 的魔怔值。
- 其他的任何信息都不会影响魔怔值,魔怔值初始为 。
现在你需要对于这些信息,计算出总的魔怔值。
输入格式
第一行三个整数 ,表示共有 条信息, 意义如题述。
接下来 行,描述每条信息:
- 第一行是第 1 类信息。
- 第二行是第 2 类或第 3 类信息。
输出格式
仅一行一个整数,即总的魔怔值。
样例
样例 1
提示
样例 1 说明
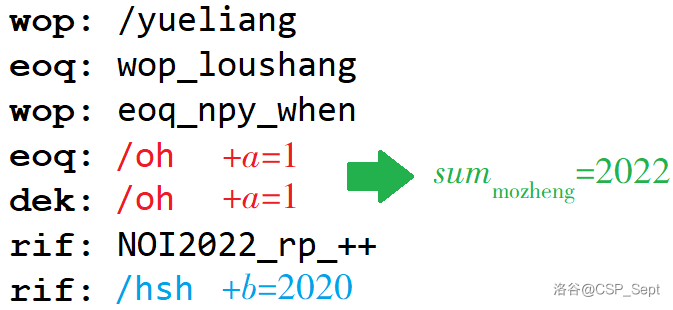
如图所示。
数据规模与约定
本题采用捆绑测试。
记 表示输入中单行信息的最大长度。
$$\newcommand{\arraystretch}{1.5} | Subtask | n≤ | 特殊性质 | 分值 | |---|---|---|---| | 1 | ≤ 10 | - | 20 分 | | 2 | ≤ 100 | - | 20 分 | | 3 | 无特殊限制 | A | 20 分 | | 4 | 无特殊限制 | - | 40 分 |$$- 特殊性质 :输入不含有第 3 类信息。
对于 的数据,有 ,,。
7 1 2020
wop:
/yueliang
eoq:
wop_loushang
wop:
eoq_npy_when
eoq:
/oh
dek:
/oh
rif:
NOI2022_rp_++
rif:
/hsh
2022